Nemotron-3-Nano: возможности модели
На главную > Блог > Категория > Nemotron-3-Nano: возможности модели
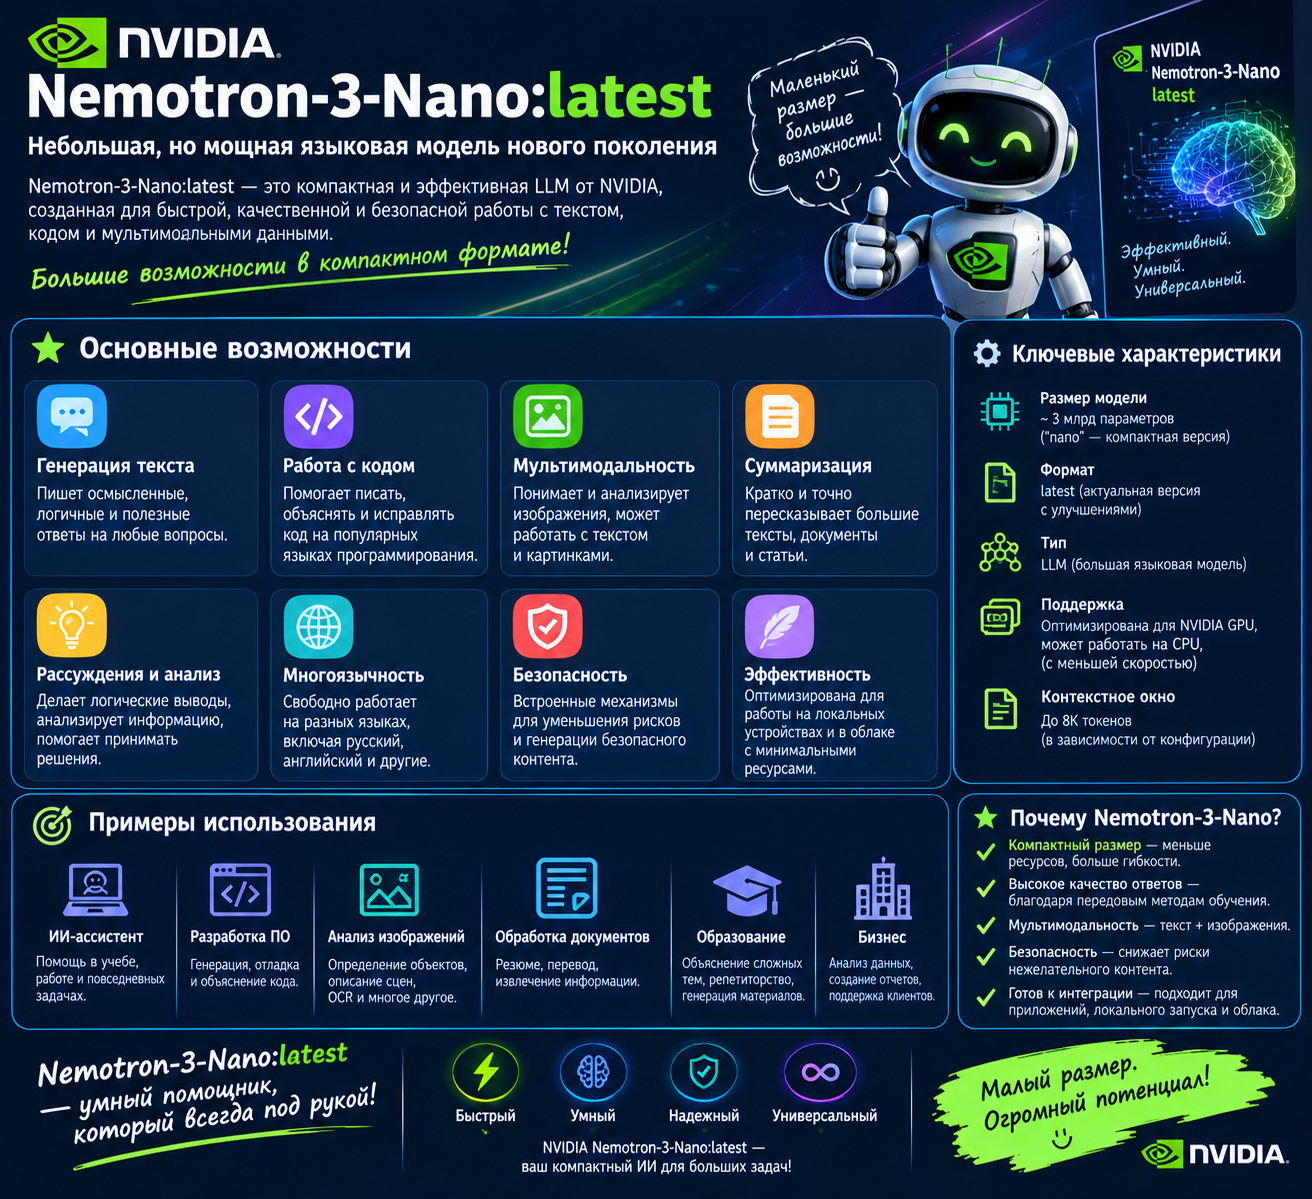
Nemotron-3-Nano — это открытая языковая модель от NVIDIA, спроектированная для агентных задач, рассуждений и работы с длинным контекстом. В семействе Nemotron 3 она занимает нишу «маленькой, но эффективной» модели: при общем числе параметров около 30 миллиардов на каждом токене активируется лишь малая часть, что делает инференс заметно дешевле и быстрее конкурентов сопоставимого размера. Ниже — разбор ключевых возможностей, архитектуры и практических ограничений.
Что такое Nemotron-3-Nano
Nemotron-3-Nano — модель семейства Nemotron 3 от NVIDIA, выпущенная в декабре 2025 года. Это открытая модель: доступны веса, тренировочные данные и рецепты обучения [citation:8][citation:10]. В семействе также заявлены Super и Ultra, но именно Nano доступна для использования уже сейчас.
Ключевые характеристики «на бумаге»:
- Общее число параметров: около 30–31,6 млрд.
- Активных параметров на токен: около 3–3,6 млрд (в зависимости от источника и способа подсчёта) [citation:2][citation:8].
- Контекстное окно: до 1 млн токенов [citation:4][citation:10].
- Лицензия: NVIDIA Open Model License [citation:2].
Именно малое число активных параметров — главная фишка. Модель «выглядит» как 30B, но по вычислительной нагрузке ближе к 3–4B. Это позволяет запускать её на относительно скромном железе и получать высокий throughput.
Архитектура: Mamba, Transformer и MoE
Nemotron-3-Nano использует гибридную архитектуру, которая сочетает три подхода в одном backbone [citation:10]:
- Mamba-2 слои — для эффективной обработки длинных последовательностей с низким потреблением памяти. Именно они позволяют удерживать контекст до 1M токенов без взрывного роста вычислений.
- Transformer-слои с attention — для точного рассуждения, работы с кодом, математикой и структурными зависимостями.
- MoE (Mixture of Experts) — маршрутизация, при которой на каждый токен активируется лишь часть «экспертов». В конфигурации Nano это 6 из 128 экспертов плюс один общий [citation:2].
Точная раскладка слоёв, по данным технического отчёта: чередование блоков Mamba-2 + MoE с редкими вкраплениями attention-слоёв. Такая схема даёт компромисс между скоростью Mamba и качеством рассуждения Transformer [citation:15].
Для практики это означает: модель хорошо держит длинный контекст и при этом не «задыхается» на задачах, где нужно думать пошагово.
Режимы reasoning и thinking
Nemotron-3-Nano — гибридная модель: она умеет и рассуждать, и отвечать «сразу». По умолчанию она генерирует reasoning trace (цепочку рассуждений), а затем финальный ответ. Это поведение можно отключить через флаг в chat template, если нужен быстрый прямой ответ [citation:2].
В токенизаторе для этого предусмотрены специальные токены:
<think> и </think> [citation:1].
На практике это значит, что при работе через API или локальный
инференс-движок вы можете управлять тем, насколько «глубоко» модель
думает перед ответом.
Отключение reasoning даёт выигрыш в скорости и токенах, но на сложных задачах (математика, код, многошаговые инструкции) качество может просесть. Включённый reasoning, наоборот, повышает точность финального решения [citation:2].
Контекст до 1M токенов
Одна из главных возможностей — контекстное окно до 1 миллиона токенов [citation:4][citation:10]. Это позволяет:
- Держать в контексте целые кодовые базы и длинные документы без нарезки на чанки.
- Вести многочасовые агентные сессии, не теряя историю.
- Загружать большие наборы найденных данных (RAG) в один контекст.
На практике локальный запуск с полным 1M контекстом требует много памяти и может привести к OOM (out of memory). В документации Unsloth указано, что по умолчанию контекст ограничен 262 144 токенами, а установка 1M может «уронить» CUDA, если у железа не хватает VRAM [citation:1][citation:5].
То есть возможность есть, но пользоваться ей стоит осознанно, под конкретную задачу и с запасом памяти.
Бенчмарки и производительность
По данным NVIDIA и независимых обзоров, Nemotron-3-Nano обходит сопоставимые открытые модели по ряду ключевых метрик.
Скорость (throughput): на конфигурации 8K вход / 16K выход на одном H200 модель показывает в 3,3 раза более высокий throughput, чем Qwen3-30B-A3B, и в 2,2 раза выше, чем GPT-OSS-20B [citation:8][citation:13]. Это прямое следствие MoE-архитектуры с малым числом активных параметров.
Качество: в техническом отчёте приводятся цифры по бенчмаркам (BF16-версия):
- MMLU-Pro: ~78,3
- AIME25 (без инструментов): ~89,1
- AIME25 (с инструментами): ~99,2
- GPQA (без инструментов): ~73,0
- LiveCodeBench: ~68,3
Эти цифры показывают, что модель сильна в математике и коде, особенно когда ей разрешено использовать инструменты [citation:4].
FP8-квантование сохраняет около 99% качества BF16-версии по медиане бенчмарков, что делает квантизованные версии практичным выбором для продакшена [citation:4].
Требования к железу
Требования зависят от того, какую версию вы запускаете.
| Версия | Память (4-bit) | Память (8-bit) | Примечание |
|---|---|---|---|
| Nano 4B | ~3 ГБ | ~5 ГБ | Запускается на слабых GPU и даже CPU [citation:1][citation:5] |
| Nano 30B-A3B | ~24 ГБ | ~36 ГБ | Требует серьёзной видеокарты или Mac с большим объёмом unified memory [citation:1][citation:5] |
Для 30B-версии на M5 Pro с 64 ГБ памяти замеры показывают около 106 токенов в секунду на генерации при контексте 1K и пиковое потребление памяти около 18–19 ГБ в 4-битном квантовании [citation:9].
Если вы работаете через Ollama, доступны команды вроде
ollama run nemotron-3-nano:30b или
ollama run nemotron-3-nano:4b [citation:2].
Языки и ограничения
По данным карточки модели на Ollama, поддерживаемые языки: английский, немецкий, испанский, французский, итальянский и японский [citation:2]. Русского языка в этом списке нет.
Это важное ограничение для русскоязычных пользователей: модель может отвечать на русском, но качество и стабильность будут ниже, чем на поддерживаемых языках. Для задач на русском стоит либо тестировать её отдельно, либо рассмотреть модели с явной поддержкой русского.
Отдельно про Nemotron-3-Nano Omni
Важно не путать: существует отдельная модель Nemotron 3 Nano Omni, которая является мультимодальной и объединяет текст, изображения, видео и аудио [citation:11][citation:12]. Она построена на той же архитектуре 30B-A3B, но с добавленными энкодерами для восприятия.
Omni-версия заявлена как лучшая в своём классе по эффективности для мультимодальных агентных задач: документы, GUI-автоматизация, анализ видео и аудио. По данным NVIDIA, она обеспечивает до 9x более высокий throughput по сравнению с другими открытыми omni-моделями при сопоставимой интерактивности [citation:11].
Если ваша задача — только текст, reasoning и код, вам подойдёт обычная Nemotron-3-Nano. Если нужна работа с изображениями или видео — смотрите в сторону Omni.
Частые вопросы
Это действительно открытая модель?
Да. NVIDIA опубликовала веса, тренировочные данные (в той части, на которую имеет права) и рецепты обучения под NVIDIA Open Model License [citation:8][citation:10].
Сколько активных параметров у модели?
Около 3–3,6 млрд на токен при общем числе параметров порядка 30–31,6 млрд. Точная цифра зависит от того, как считать эмбеддинги [citation:2][citation:8].
Можно ли запустить на обычном ноутбуке?
4B-версию — да, в 4-битном квантовании ей хватит около 3 ГБ памяти [citation:1]. 30B-версию — только если у вас есть GPU с 24+ ГБ VRAM или Mac с большим объёмом unified memory.
Поддерживает ли она русский язык?
Официально в списке поддерживаемых языков русского нет [citation:2]. Модель может генерировать текст на русском, но качество не гарантируется на уровне поддерживаемых языков.
Что такое режим reasoning и зачем он нужен?
Это генерация цепочки рассуждений перед финальным ответом. Включённый reasoning повышает точность на сложных задачах, выключенный — ускоряет ответ и экономит токены [citation:2].
Чем Omni отличается от обычной Nano?
Omni — мультимодальная версия: она понимает изображения, видео и аудио в дополнение к тексту. Обычная Nano работает только с текстом [citation:11].
Итог: Nemotron-3-Nano — это модель для тех, кому нужен длинный контекст, высокая скорость инференса и агентные сценарии без затрат на гигантский кластер. Сильные стороны — гибридная архитектура, throughput и открытость. Ограничения — языковой состав, требования к памяти для полного контекста и то, что 30B-версия всё же требует серьёзного железа. Для русского языка модель стоит тестировать отдельно, прежде чем строить на ней продакшен.
Дата размещения статьи: 24-10-2026 в 12:54:14