Самые мощные модели в библиотеке Ollama
На главную > Блог > Категория > Самые мощные модели в библиотеке Ollama
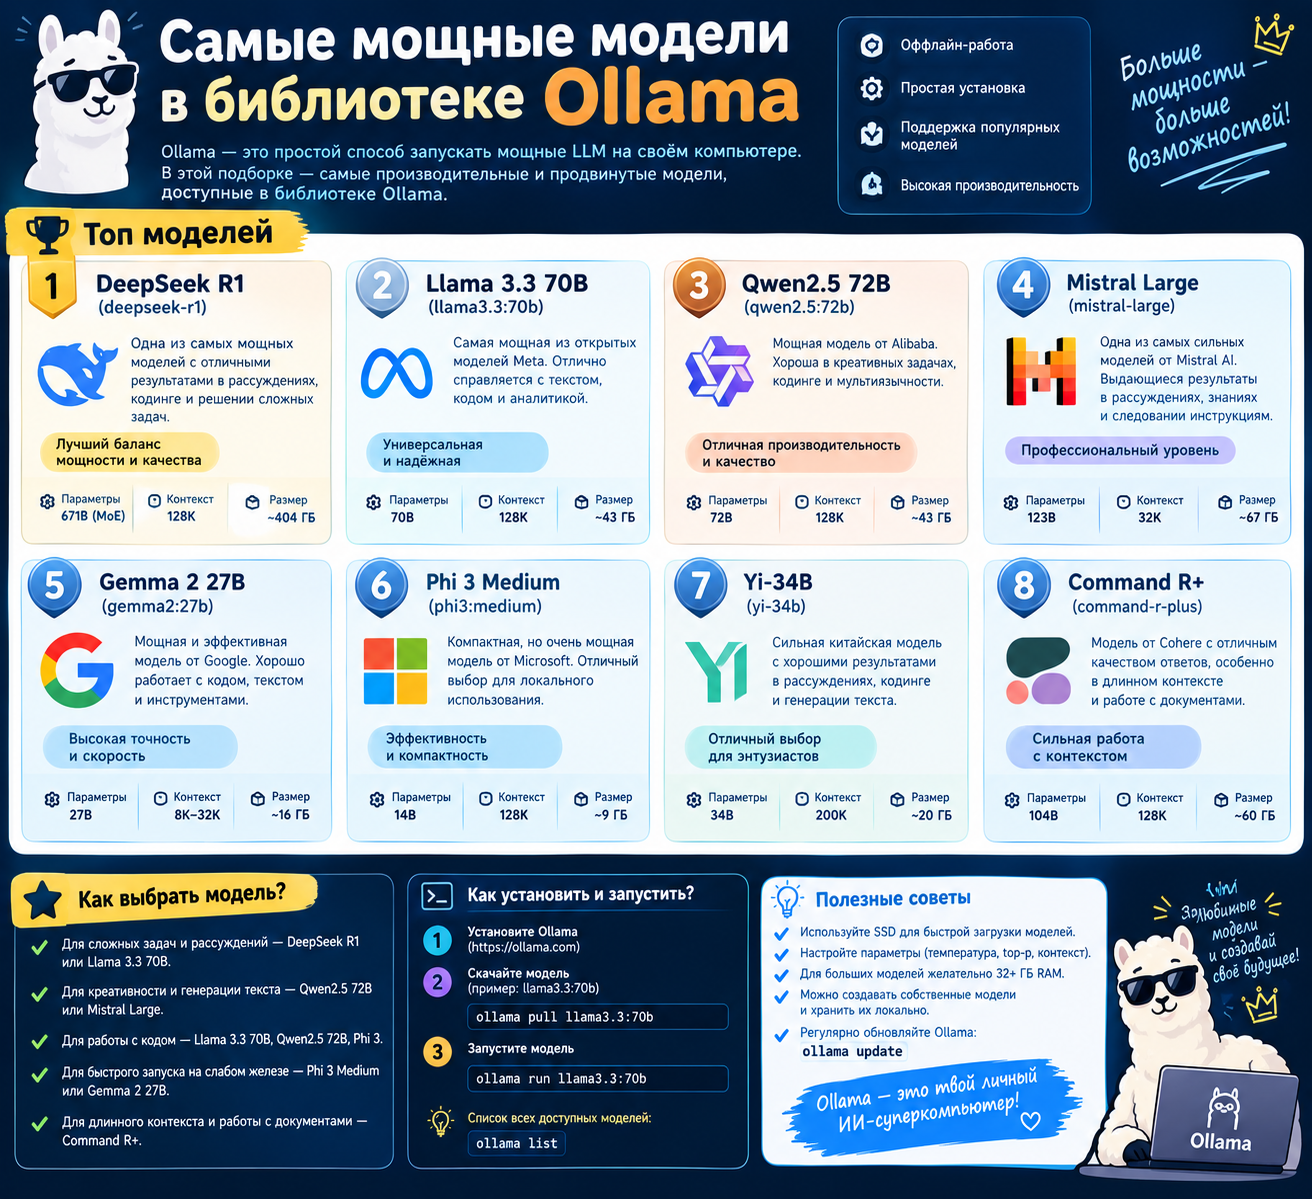
Библиотека Ollama — это не только лёгкие модели для ноутбуков. В ней есть и по-настоящему тяжёлые экземпляры: смеси экспертов (MoE) на сотни миллиардов параметров, которые по качеству рассуждений приближаются к проприетарным флагманам. Правда, есть нюанс: «самая мощная» и «самая практичная» — это разные вещи. Ниже — разбор того, что действительно является топом по бенчмаркам, и того, что реально можно запустить на своём железе.
Топ по бенчмаркам: дата-центровые гиганты
Если отбросить вопросы практичности и смотреть только на цифры, лидеры библиотеки Ollama по состоянию на октябрь 2026 выглядят так. Все они — открытые MoE-модели, и все они требуют серьёзного оборудования.
| Модель | Оценка (BenchLM) | Параметры | Размер Q4 | Минимальное железо |
|---|---|---|---|---|
| Kimi K2.6 (Moonshot AI) | 58.38 | 1000B MoE (32B активных) | ~600 ГБ | 8× NVIDIA H100 (80 ГБ) |
| GLM-5.1 (Z.AI) | 56.27 | 744B MoE (40B активных) | ~446 ГБ | 8× NVIDIA H100 (80 ГБ) |
| Kimi K2.5 (Moonshot AI) | 53.03 | 120B dense | ~72 ГБ | 4× NVIDIA A100 (80 ГБ) |
| DeepSeek-R1 | 41.03 | 671B MoE (37B активных) | ~403 ГБ | 8× NVIDIA H100 (80 ГБ) |
Kimi K2.6 — абсолютный лидер по качеству среди того, что можно запустить через Ollama [citation:1]. Это модель на 1000 миллиардов параметров, но благодаря MoE на каждом токене активируется только около 32 миллиардов. Именно поэтому она вообще работает, а не требует отдельного дата-центра на каждый запрос.
GLM-5.1 от Z.AI чуть отстаёт по общей оценке, но традиционно сильна в вызове инструментов (tool calling) и структурированной экстракции данных [citation:1]. Если вы строите агентные пайплайны, это может быть важнее общей оценки.
Команды загрузки:
ollama pull kimi-k2
ollama pull glm
ollama pull deepseek-r1:671b
Важно: это модели для серверов. На домашнем компьютере их не запустить, если только у вас нет восьми H100 под столом.
Самые мощные из практичных
Для обычного пользователя с одной видеокартой на 24 ГБ (например, RTX 4090) или Mac с 32–64 ГБ объединённой памяти реальный топ выглядит иначе. Здесь лидирует Qwen3.6-27B.
Qwen3.6-27B — это плотная (dense) модель на 27 миллиардов параметров. В квантовании Q4 она занимает около 16 ГБ и помещается на одну 24-гигабайтную карту. Её оценка в BenchLM — 48.53, что ниже гигантов из предыдущего раздела, но для своего размера это очень высокий результат [citation:1]. В частности, на SWE-bench Verified (задачи по программированию) она показывает 77.2, что делает её одним из лучших практичных выборов для кода.
Рядом стоит Qwen3.6-35B-A3B — MoE-версия на 35 миллиардов параметров с 3 миллиардами активных. Она занимает около 21 ГБ и тоже помещается на 24-гигабайтную карту или Mac с 32 ГБ памяти. Оценка чуть ниже (43.36), но скорость работы за счёт малого числа активных параметров может быть заметно выше [citation:1].
Gemma 4 31B от Google — ещё один вариант для одной карты на 24 ГБ. Оценка 39.84, около 19 ГБ в Q4. Она уступает Qwen по общим бенчмаркам, но если вы уже работаете в экосистеме Google или вам нужна специфическая настройка, это достойный выбор [citation:1].
Команды:
ollama pull qwen3.6
ollama pull gemma4
Лучшие для кода
Если ваша задача — генерация и анализ кода, выбор сужается.
- Qwen3.6-27B. Лучший баланс качества и требований к железу. SWE-bench Verified 77.2, помещается на одну 24-гигабайтную карту [citation:1].
- Nemotron-3.5-bolt:74b-a9b. Более специализированный вариант от NVIDIA. 74B MoE с 9B активных, около 25 ГБ в IQ2-квантовании. Поддерживает ввод изображений, что полезно для разбора скриншотов кода или диаграмм. Требует 32 ГБ памяти [citation:3].
- Qwen3-Coder-Next (community build). 80B MoE, конвертация от Unsloth, требует около 48 ГБ памяти. Если у вас есть такая конфигурация, это один из самых сильных вариантов для кодинга [citation:7].
Лучшие для рассуждений
Для задач, где нужно «думать пошагово» — математика, логика, сложные инструкции — стоит смотреть в сторону моделей с поддержкой reasoning-режима.
- DeepSeek-R1. Классика жанра. Даже дистиллированные версии (7B, 14B, 32B) показывают хорошие результаты для своего размера. Полная версия на 671B — это уже дата-центровый вариант, но дистилляты доступны и на обычном железе [citation:1].
- Qwen3.6-27B. Поддерживает режим размышлений (thinking) и показывает сильные результаты на математических бенчмарках. Практичный выбор, если нужно и рассуждение, и код, и всё это на одной карте.
- GLM-5.1. Если у вас есть серверное железо, эта модель сильна в агентных сценариях и многошаговых задачах [citation:1].
Что нужно для запуска
Простое правило: в квантовании Q4_K_M модель занимает примерно 0,6 ГБ на каждый миллиард параметров [citation:1]. Отсюда:
- 8 ГБ VRAM. Модели до 12–13B. Например, Gemma 4 12B (~7 ГБ) или Qwen3.5:9B.
- 24 ГБ VRAM. Qwen3.6-27B (~16 ГБ) или Gemma 4 31B (~19 ГБ). Это «золотая середина» для энтузиастов.
- 32–64 ГБ (Mac unified memory). Qwen3.6-35B-A3B или Nemotron-3.5-bolt.
- 80+ ГБ VRAM. Начинаются серьёзные MoE: Kimi K2.5 (~72 ГБ), DeepSeek-R1 671B (~403 ГБ), GLM-5.1 (~446 ГБ), Kimi K2.6 (~600 ГБ).
Для моделей, которые не помещаются в VRAM целиком, Ollama умеет выгружать часть слоёв в оперативную память, но скорость при этом падает. Если вы не готовы к этому, лучше ориентироваться на модели, которые влезают в видеопамять полностью.
Частые вопросы
Можно ли запустить Kimi K2.6 на домашнем компьютере?
Нет. Ей нужно около 600 ГБ памяти только под веса, и это без учёта контекста. Для неё требуется сервер с восемью H100 или аналогичной конфигурацией [citation:1].
Какая самая мощная модель, которую можно запустить на RTX 4090?
Qwen3.6-27B. Она занимает около 16 ГБ в Q4 и помещается на 24-гигабайтную карту с запасом. Альтернативы — Qwen3.6-35B-A3B (21 ГБ) или Gemma 4 31B (19 ГБ) [citation:1].
Почему Qwen3.6-27B считается лучше моделей на 70B?
Не «лучше» в абсолютном смысле, а эффективнее. Старые плотные модели на 70B требуют больше памяти и работают медленнее, а Qwen3.6-27B за счёт более современной архитектуры и обучения показывает сопоставимые или лучшие результаты на многих практических задачах [citation:1][citation:11].
Что означает «MoE» и почему это важно?
Mixture of Experts — архитектура, при которой на каждом токене активируется только часть параметров. Например, у Kimi K2.6 всего 1000B параметров, но активных — только 32B. Это позволяет держать в памяти огромную модель, но не тратить вычисления на все параметры сразу.
Стоит ли качать самую большую модель, если железо позволяет?
Если железо действительно позволяет — да, качество будет выше. Но если модель не помещается в VRAM и выгружается в RAM, скорость может упасть настолько, что работа станет некомфортной. Лучше взять модель поменьше, но полностью в видеопамяти.
Дата размещения статьи: 25-10-2026 в 13:54:36