Где используется библиотека Pandas (практический пример)
На главную > Блог > Категория > Где используется библиотека Pandas (практический пример)
Что такое Pandas и где она применяется
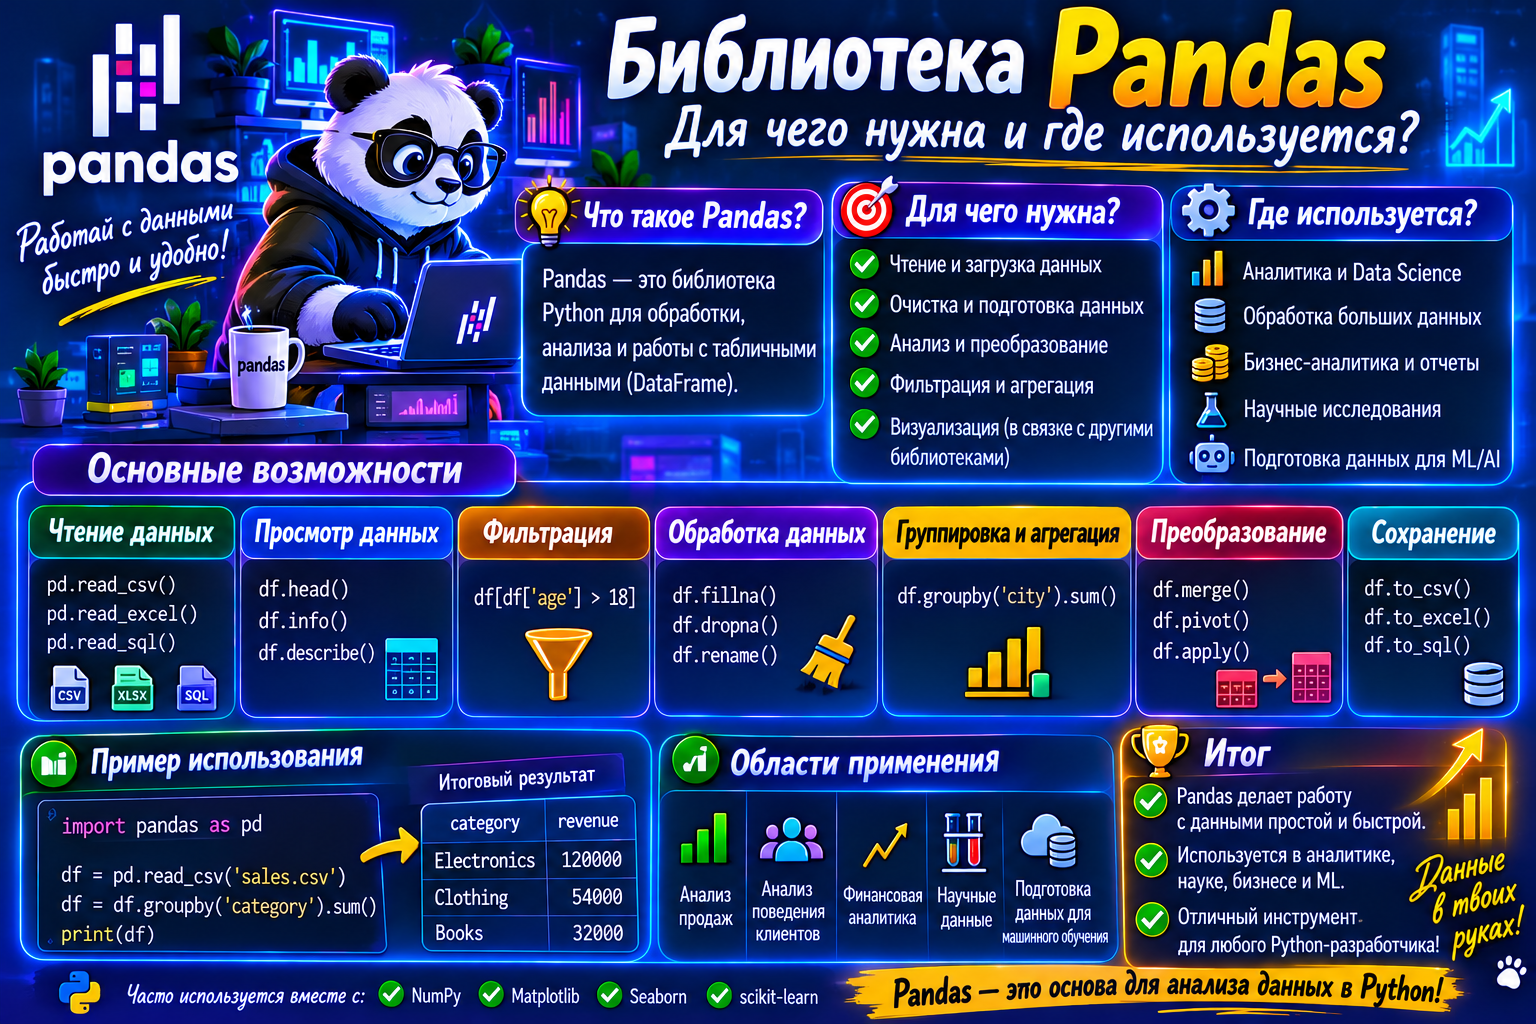
Pandas — это open-source библиотека для анализа и обработки данных. Она предоставляет две основные структуры: Series (одномерный массив с метками) и DataFrame (двумерная таблица, похожая на лист Excel или таблицу в SQL) [citation:2][citation:8]. Именно DataFrame делает Pandas таким удобным для работы с реальными данными.
Где же она используется на практике? Практически везде, где есть таблицы:
- Финансы и аналитика. Расчет доходности, анализ котировок, построение отчетов.
- Маркетинг и продажи. Анализ воронки, сегментация клиентов, расчет LTV.
- Наука и инженерия. Обработка результатов экспериментов, очистка логов датчиков.
- Подготовка данных для ML. Pandas — стандартный инструмент для предобработки данных перед подачей в Scikit-learn, TensorFlow или PyTorch .
В официальной документации Pandas прямо сказано, что библиотека создана для «практического анализа данных в реальном мире» [citation:10]. Давайте посмотрим, как это выглядит в коде.
Практический пример: анализ продаж
Представим, что мы работаем аналитиками в интернет-магазине. У нас есть выгрузка продаж за месяц в формате CSV. В файле есть колонки: order_id (номер заказа), date (дата), region (регион), category (категория товара) и amount (сумма). Наша задача — понять, какой регион принес больше всего денег, и найти средний чек.
Шаг 1. Загрузка данных
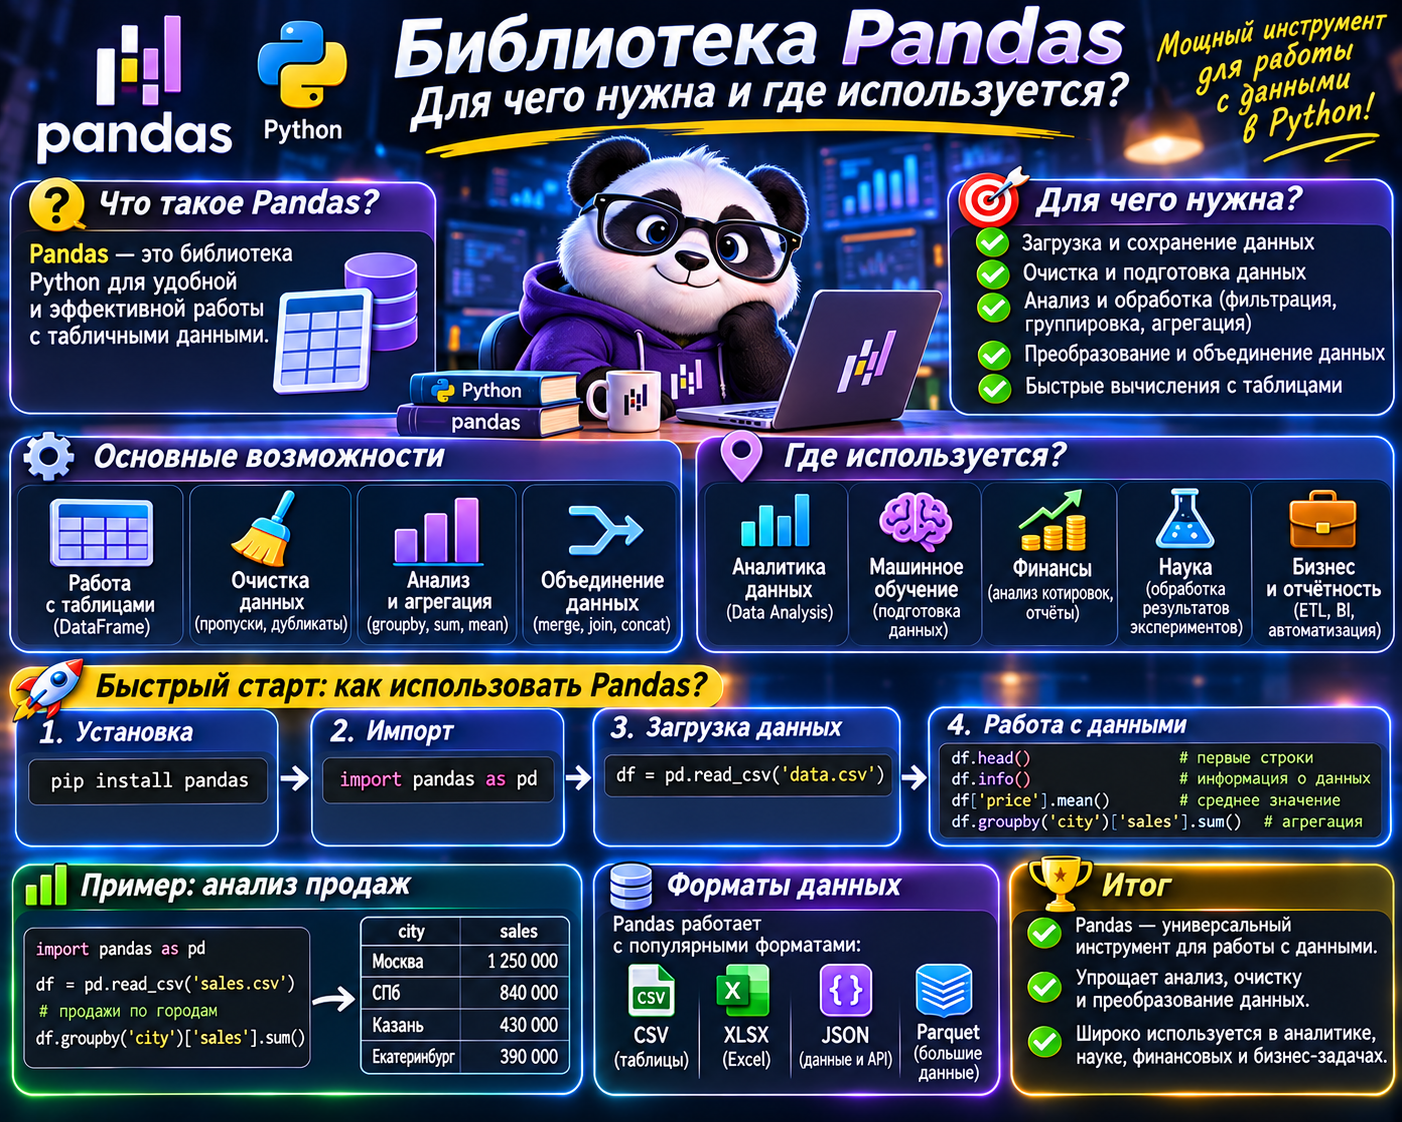
Первое, что мы делаем — импортируем библиотеку и читаем файл. Pandas поддерживает множество форматов: CSV, Excel, JSON, SQL и другие [citation:2]. Для CSV используется функция read_csv().
import pandas as pd

# Загружаем данные из CSV-файла
df = pd.read_csv('sales_data.csv')

# Смотрим на первые 5 строк, чтобы понять структуру
print(df.head())
Если данные лежат в Excel, достаточно заменить одну строчку на pd.read_excel('sales_data.xlsx').
Шаг 2. Очистка и подготовка
Реальные данные почти всегда «грязные». В нашем файле могут быть пропуски в колонке amount или дубликаты заказов. Pandas позволяет быстро это исправить.
# Проверяем, сколько пропусков в каждой колонке
print(df.isnull().sum())

# Удаляем строки, где не указана сумма (нам они не нужны для анализа)
df = df.dropna(subset=['amount'])

# Удаляем дубликаты по номеру заказа
df = df.drop_duplicates(subset=['order_id'])

# Преобразуем колонку с датой в формат datetime (полезно для анализа по времени)
df['date'] = pd.to_datetime(df['date'])
Эти несколько строк кода заменяют часы ручной работы в Excel. Pandas автоматически выравнивает данные и позволяет применять операции к целым колонкам без циклов [citation:2].
Шаг 3. Анализ и группировка
Теперь самое интересное — анализ. Мы хотим узнать общую сумму продаж по регионам и средний чек. Для этого используем мощный метод groupby(), который реализует подход «split-apply-combine» (разделить-применить-объединить) [citation:2][citation:10].
# Группируем по региону и считаем сумму и среднее значение
region_stats = df.groupby('region')['amount'].agg(['sum', 'mean', 'count'])

# Сортируем по общей сумме продаж (от большего к меньшему)
region_stats = region_stats.sort_values(by='sum', ascending=False)

print(region_stats)
В результате мы получим таблицу, где для каждого региона видно: сколько всего было продано (sum), средний чек (mean) и количество заказов (count). Это готовый отчет, который можно сразу отправлять руководству.
Также мы можем быстро получить общую статистику по всем числовым колонкам с помощью df.describe() [citation:8].
Шаг 4. Визуализация
Pandas умеет строить графики «из коробки» на основе Matplotlib. Не нужно импортировать дополнительные библиотеки, если нужен быстрый взгляд на данные [citation:2].
# Строим столбчатую диаграмму по суммам продаж в регионах
region_stats['sum'].plot(kind='bar', title='Продажи по регионам')

# Если вы работаете в Jupyter Notebook, график появится прямо в ячейке.
# В обычном скрипте нужно добавить import matplotlib.pyplot as plt и plt.show()
Такой график сразу показывает, какой регион лидирует, а где стоит усилить маркетинг. Для более сложных визуализаций Pandas легко интегрируется с Seaborn и Plotly.
Частые вопросы
Pandas заменяет Excel?
Для больших объемов данных и автоматизации — да. Pandas обрабатывает миллионы строк быстрее и позволяет воспроизводить анализ кодом, а не кликами мышью. Но для быстрых визуальных правок Excel все еще удобен [citation:1][citation:5].
Нужно ли знать NumPy, чтобы использовать Pandas?
Базовое понимание массивов полезно, так как Pandas построен на NumPy. Но для большинства задач достаточно знать сам Pandas: его методы read_*, groupby, merge и фильтрацию.
С какими объемами данных справляется Pandas?
Pandas отлично работает с данными до нескольких миллионов строк на обычном ноутбуке (в зависимости от количества колонок и доступной RAM). Для терабайтных данных используют Apache Spark или Dask, но Pandas остается стандартом для средних объемов.
Итог: Pandas — это «швейцарский нож» для работы с табличными данными. Мы прошли путь от загрузки CSV до готового графика всего за несколько строк кода. Если вы планируете заниматься анализом данных, машинным обучением или просто хотите автоматизировать рутинные отчеты, Pandas — обязательный инструмент в вашем арсенале.
Дата размещения статьи: 04-11-2026 в 08:02:49