Что такое PyTorch и как его использовать на практике
На главную > Блог > Категория > Что такое PyTorch и как его использовать на практике
Что такое PyTorch и зачем он нужен
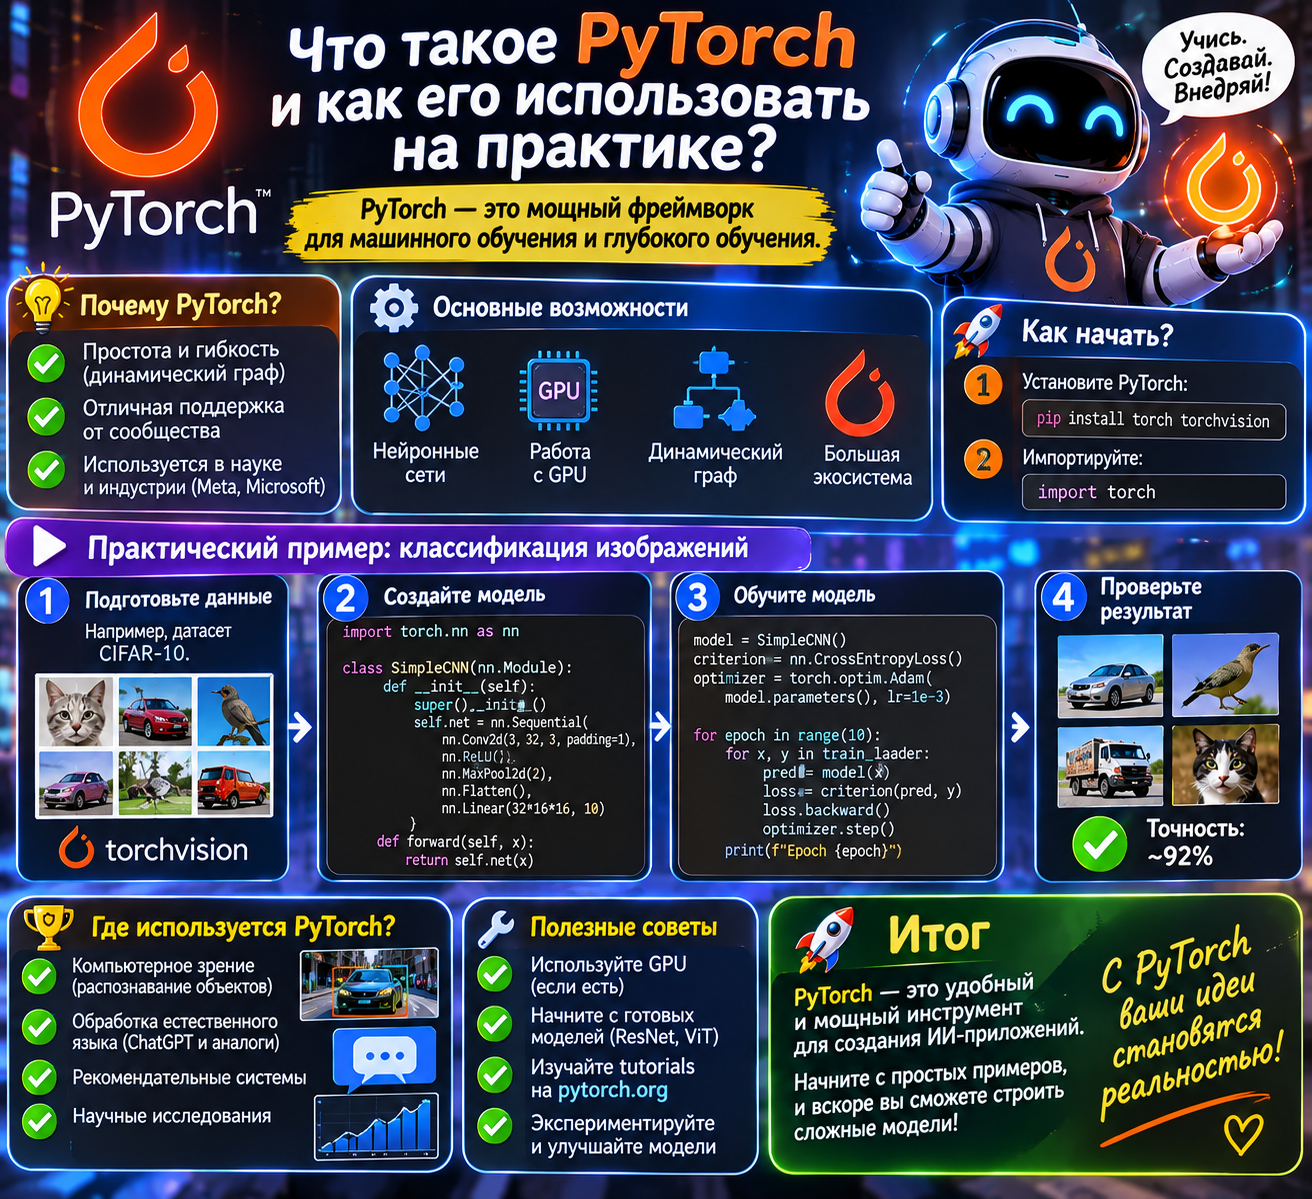
PyTorch — это фреймворк с открытым исходным кодом для создания и обучения нейронных сетей на Python. Его часто используют исследователи, специалисты по данным и разработчики ML-систем. Например, команда OpenAI использует PyTorch для разработки новых архитектур, а инженеры Uber и Netflix — для создания рекомендательных систем [citation:13].
Главное преимущество PyTorch — гибкость. Вы можете быстро создавать модели разной сложности, менять архитектуру на ходу и отлаживать код как обычную программу на Python. Именно поэтому PyTorch стал стандартом де-факто в исследовательской среде, а затем перекочевал в индустрию.
Если вы знакомы с NumPy, PyTorch покажется вам во многом похожим: те же операции с массивами, тот же синтаксис. Разница в том, что PyTorch умеет выполнять вычисления на GPU (графических процессорах), что ускоряет работу в 10–50 раз на тяжёлых задачах [citation:13].
Из чего состоит PyTorch
Фреймворк строится на трёх ключевых компонентах, которые работают в связке [citation:13].
- Тензоры (Tensors). Это многомерные массивы данных, оптимизированные для параллельных вычислений на GPU. Одномерный тензор — это вектор, двумерный — матрица, трёхмерный — «куб» чисел. Всё, что проходит через нейросеть, — это тензоры.
- Вычислительные графы (Computational Graphs). Это «чертёж» операций: какие данные с какими математическими действиями складываются, умножаются и передаются дальше. В PyTorch графы строятся динамически, прямо во время выполнения кода, что делает отладку гораздо проще.
- Автоматическое дифференцирование (Autograd). Механизм, который автоматически вычисляет градиенты — то есть показывает, как нужно изменить веса сети, чтобы уменьшить ошибку. Вам не нужно вручную выводить производные: PyTorch делает это сам.
Вместе эти три компонента позволяют описать нейросеть, скормить ей данные, получить ошибку и обновить веса — и всё это в несколько десятков строк кода.
Практика: первая нейросеть
Разберём простой пример: сеть, которая принимает четыре входных значения и предсказывает три класса. Это классическая задача классификации.
Сначала определим архитектуру. В PyTorch модели наследуются от
класса nn.Module [citation:1].
import torch
import torch.nn as nn
import torch.nn.functional as F

class MyNet(nn.Module):
    def __init__(self):
        super(MyNet, self).__init__()
        self.layer1 = nn.Linear(4, 5)
        self.layer2 = nn.Linear(5, 5)
        self.layer3 = nn.Linear(5, 3)

    def forward(self, x):
        x = F.relu(self.layer1(x))
        x = F.relu(self.layer2(x))
        y = self.layer3(x)
        return y

model = MyNet()
Что здесь происходит: __init__ определяет слои
(три линейных слоя), а forward описывает, как данные
проходят через них. Функция активации ReLU применяется после
первых двух слоёв, чтобы сеть могла выучить нелинейные
зависимости [citation:1].
После определения класса создаётся экземпляр модели — model.
Это ещё необученная сеть, но у неё уже есть веса (случайные),
которые можно тренировать.
Полный цикл обучения
В реальной работе одного определения модели недостаточно. Нужны данные, функция потерь и оптимизатор. Вот как выглядит стандартный цикл обучения в PyTorch.
Шаг 1. Подготовка данных. Данные нужно превратить
в тензоры и загрузить в DataLoader, который разбивает
их на батчи. Это позволяет обучать модель порциями, а не всей
выборкой сразу [citation:1].
import torch.utils.data as td

# Пример: train_x и train_y — массивы NumPy
train_x = torch.Tensor(train_x).float()
train_y = torch.Tensor(train_y).long()

dataset = td.TensorDataset(train_x, train_y)
loader = td.DataLoader(dataset, batch_size=20, shuffle=True)
Шаг 2. Функция потерь и оптимизатор. Для
классификации обычно используют CrossEntropyLoss.
Оптимизатор (например, Adam или SGD) обновляет веса модели
на основе градиентов [citation:10].
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
Шаг 3. Цикл обучения. Для каждой порции данных: обнуляем градиенты, делаем прямой проход, считаем ошибку, делаем обратный проход и обновляем веса.
for epoch in range(10):
    for batch_x, batch_y in loader:
        optimizer.zero_grad()          # обнуляем градиенты
        output = model(batch_x)        # прямой проход
        loss = loss_fn(output, batch_y) # считаем ошибку
        loss.backward()                # обратный проход
        optimizer.step()               # обновляем веса
Это и есть весь магический цикл. После нескольких эпох (проходов по всему датасету) модель начинает показывать осмысленные результаты. Останется только проверить её на тестовых данных и сохранить.
Почему выбирают PyTorch
- Динамические графы. Вы можете менять логику модели прямо во время выполнения, использовать условия и циклы — это делает код гибким и понятным.
- Pythonic-синтаксис. Код на PyTorch выглядит как обычный Python, а не как отдельный язык описания графов. Это снижает порог входа.
- Огромная экосистема.
torchvisionдля компьютерного зрения,transformersдля текста,torchaudioдля звука — готовые инструменты на все случаи [citation:13]. - Поддержка сообщества. Большинство исследовательских статей выходят с кодом на PyTorch, а на GitHub проще найти готовые реализации.
Частые вопросы
Нужна ли видеокарта для PyTorch?
Для обучения небольших моделей достаточно CPU. Но если вы работаете с изображениями, видео или большими языковыми моделями, GPU ускорит процесс в десятки раз. PyTorch автоматически использует GPU, если он доступен и код написан соответствующим образом.
Чем PyTorch отличается от TensorFlow?
Оба фреймворка решают одни и те же задачи. Исторически TensorFlow использовал статические графы (нужно было сначала определить всю сеть, потом запустить), а PyTorch — динамические (граф строится по ходу выполнения). Сейчас оба поддерживают оба подхода, но PyTorch считается более гибким и удобным для исследований.
С чего начать изучение PyTorch?
С официального туториала «Learn the Basics» на сайте PyTorch [citation:2]. Он проводит через полный цикл: тензоры, датасеты, построение модели, autograd, оптимизация и сохранение. Если вы уже знаете NumPy, освоение пойдёт быстрее.
Можно ли использовать PyTorch в продакшене?
Да. PyTorch имеет инструменты для экспорта моделей (TorchScript, ONNX) и развёртывания. Многие компании используют его в production-системах.
Итог: PyTorch — это гибкий и мощный инструмент для глубокого обучения, который стоит освоить, если вы хотите работать с нейросетями. Начните с тензоров и простой модели, затем пройдите полный цикл обучения — и вы увидите, что за всей «магией» стоит понятная и логичная механика.
Дата размещения статьи: 02-11-2026 в 17:34:09