Практический пример использования TensorFlow
На главную > Блог > Категория > Практический пример использования TensorFlow
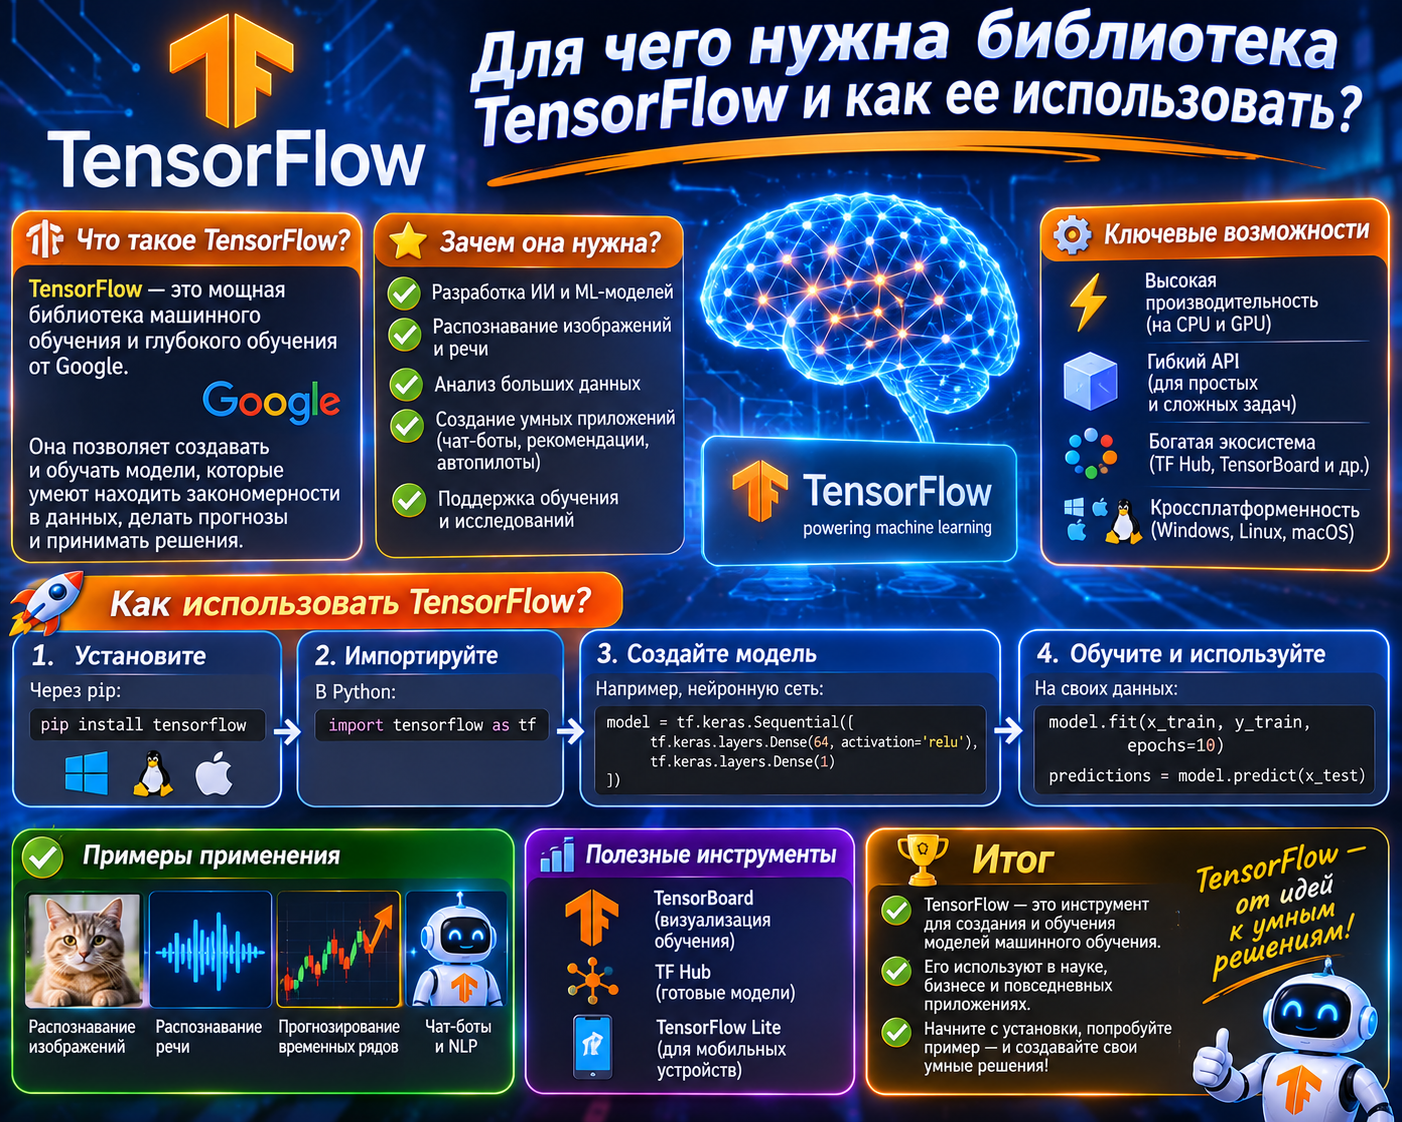
Теория хороша, но лучше всего понять инструмент, когда напишешь на нём рабочий код. Ниже — классический пример: мы научим нейросеть распознавать рукописные цифры (от 0 до 9). В этом примере используются высокоуровневый API Keras (встроенный в TensorFlow) и встроенный датасет MNIST. Весь код можно запустить в Google Colab или локально в Jupyter Notebook.
Шаг 1. Импорт и загрузка данных
Сначала импортируем TensorFlow и загрузим датасет. MNIST содержит 60 000 изображений для обучения и 10 000 для тестирования. Каждое изображение — это картинка 28×28 пикселей в оттенках серого.
import tensorflow as tf

# Загружаем встроенный датасет MNIST
mnist = tf.keras.datasets.mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()

print(f"Размер обучающей выборки: {x_train.shape[0]} изображений")
print(f"Размер тестовой выборки: {x_test.shape[0]} изображений")
Шаг 2. Подготовка данных
Нейросети лучше всего работают с числами от 0 до 1. Поэтому значения пикселей (от 0 до 255) нужно нормализовать, разделив их на 255.0.
# Нормализация данных
x_train, x_test = x_train / 255.0, x_test / 255.0

# Вывод формы одного изображения для проверки
print(f"Форма одного изображения: {x_train[0].shape}")
Шаг 3. Построение модели
Создадим простую нейронную сеть с помощью tf.keras.Sequential.
Она будет состоять из нескольких слоёв:
- Flatten: превращает двумерную матрицу 28×28 в одномерный вектор длиной 784.
- Dense (128): скрытый слой со 128 нейронами и функцией активации ReLU.
- Dropout (0.2): отключает 20% нейронов во время обучения, чтобы предотвратить переобучение.
- Dense (10): выходной слой с 10 нейронами (по одному на каждую цифру) и активацией Softmax, которая выдаёт вероятности.
    model = tf.keras.models.Sequential([
    tf.keras.layers.Flatten(input_shape=(28, 28)),
    tf.keras.layers.Dense(128, activation='relu'),
    tf.keras.layers.Dropout(0.2),
    tf.keras.layers.Dense(10, activation='softmax')
])

model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])
Шаг 4. Обучение
Запускаем процесс обучения. epochs=5 означает, что модель
пройдёт по всему обучающему набору данных 5 раз. Обычно для MNIST
этого достаточно, чтобы достичь точности выше 97%.
# Обучение модели
history = model.fit(x_train, y_train, epochs=5, validation_split=0.1)
В процессе вы увидите, как функция потерь (loss) падает, а точность (accuracy) растёт с каждой эпохой.
Шаг 5. Оценка и предсказание
Теперь проверим, как модель справляется с теми данными, которые она никогда не видела (тестовая выборка).
# Оценка точности на тестовых данных
test_loss, test_acc = model.evaluate(x_test, y_test)
print(f"Точность на тестовых данных: {test_acc:.4f}")

# Делаем предсказание для первых 3 изображений
import numpy as np

predictions = model.predict(x_test[:3])
predicted_classes = np.argmax(predictions, axis=1)
actual_classes = y_test[:3]

print(f"Предсказанные цифры: {predicted_classes}")
print(f"Настоящие цифры:     {actual_classes}")
Функция model.predict() возвращает массив вероятностей для
каждого класса. np.argmax() находит индекс с наибольшей
вероятностью — это и есть предсказанная цифра.
Что дальше? Обученную модель можно сохранить командой
model.save('my_model.keras') и в дальнейшем конвертировать в
TensorFlow Lite для запуска на смартфоне или в TensorFlow.js для работы
в браузере.
Итог: мы прошли полный цикл — от загрузки данных до предсказаний. Около 20 строк кода на TensorFlow/Keras позволяют создать и обучить нейросеть, которая понимает рукописные цифры. Этот шаблон — отправная точка для более сложных задач: заменяйте данные и меняйте архитектуру, чтобы решать свои задачи.
Дата размещения статьи: 04-11-2026 в 07:50:25